Introduction — Réseaux sociaux : Le mirage de l’agora numérique
Il n’est pas simple de définir ce qu’est un réseau social pour la simple et bonne raison que selon l’usage qui en est fait, la définition peut diverger. En sciences de l’information et de la communication, les réseaux sociaux numériques les plus consultés (Facebook, Instagram, TikTok, Snapchat, Twitter/X, YouTube, Twitch, etc.) sont – sans que ces définitions soient exclusives – tantôt considérés comme :
-des dispositifs d’écriture numérique (Julliard, 2022 ; Souchier et al., 2019 ; Allard, 2020) ;
-des outils de militantisme (Jouët, 2022 ; Despontin-Lefevre, 2019 ; Bouté, 2021) ;
-des médias de divertissement (Bullich et al., 2025 ; Louessard, 2018) et d’information (Rebillard & Smyrnaios, 2010) ;
-des entreprises marchandes (Zuboff, 2020 ; Smyrnaios, 2025) détenues par de grands entrepreneurs comme Elon Musk ou Mark Zuckerberg (Galluzzo, 2023 ; Alexandre, 2023).
Si les réseaux sociaux numériques mainstream sont distribués et utilisés par des internautes aux quatre coins du globe, ils sont, pour la plupart, d’origine américaine (comme le groupe Meta qui détient Facebook, Instagram, Threads et WhatsApp) et, pour d’autres, d’origine chinoise (comme le groupe Bytedance à qui appartient TikTok, anciennement Musica.ly). Ainsi, derrière l’interface fluide d’Instagram, de TikTok ou de X, se cachent d’innombrables batailles juridiques et idéologiques, des problématiques informatiques, des collectes et des méthodes de traitement complexes de très larges jeux de données personnelles, des frictions interculturelles et, pour ainsi dire, le miroir grossissant des maux de nos sociétés.
Si l’on reconnaît aux réseaux sociaux numériques leur rôle dans la structuration de mouvements politiques (comme les printemps arabes, le mouvement des Indignados en Espagne, les Gilets jaunes en France et Black Lives Matter aux États-Unis) ou de « libération de la parole » (à l’image de #MeToo), on reproche également à leurs concepteurs leur négligence en matière de lutte contre la haine en ligne, de désinformation ou plus largement, de diffusion de contenus illicites à grande échelle. En cause, le plus souvent, le fonctionnement de la modération – jugée tour à tour insuffisante ou discriminante à l’égard de communautés minorisées sur la base de leur genre, de leur orientation sexuelle, de leur langue ou de leur origine ethnique.
Dans un contexte de déploiement croissant de technologies algorithmiques, les dispositifs de modération et de recommandation de contenus se complexifient. Il ne s’agit plus seulement de dire « non » à la publication d’un contenu, mais bien de définir les échelles de visibilité des contenus : faut-il les supprimer, les suspendre, les restreindre, selon les âges ou les zones géographiques ? Ces décisions opaques concernant ce qui est vu ou invisibilisé en ligne font l’objet de tensions. Car, modérer, ce n’est pas seulement supprimer – cela revient à définir ce qui mérite d’être vu, lu, entendu en ligne et dans l’espace public. Cela revient donc aussi, dans certains cas, à censurer.
Dans les lignes qui suivent, nous présenterons aux lecteur-rices quelques principes sur le fonctionnement de la modération (algorithmique) des réseaux sociaux numériques et les tactiques que les internautes mettent en place pour la déjouer. Cet article proposera d’éclairer les mécanismes de cette invisibilisation et offrira quelques pistes de réflexion pour une éducation aux réseaux sociaux numériques et aux algorithmes à des jeunes publics. Nous l’avons pensé à partir d’une enquête doctorale menée entre 2020 et 2024 en sciences de l’information et de la communication qui portait sur l’enjeu des discriminations algorithmiques dans le contexte de la modération des réseaux sociaux numériques (voir Grison, 2024a).
Nous suivrons donc le plan suivant : après une introduction au fonctionnement et aux principes de modération des réseaux sociaux numériques, nous présenterons la façon dont les communautés en ligne détournent les dispositifs de modération pour se rendre (in-)visibles en ligne et enfin nous conclurons par une ouverture sur un atelier d’auto-ethnographie en ligne que l’on peut mettre en place dans un contexte pédagogique pour mieux comprendre le fonctionnement de la recommandation personnalisée sur les réseaux sociaux.
Définition et fonctionnement de la modération sur les réseaux sociaux numériques : entre textes, humains et machines
La modération de contenus est parfois perçue comme une application de règles binaires qui consisterait exclusivement à interdire ou autoriser la publication et la diffusion de propos et de contenus audiovisuels en ligne. En réalité, elle repose sur un agencement tripartite que l’on peut visualiser comme un mille-feuille socio-technique et qui diverge d’un réseau social à l’autre (Badouard, 2020).
Les enjeux liés à la modération des contenus ne sont pas apparus avec les réseaux sociaux contemporains. Avec les premières formes de communication en ligne, notamment les Bulletin Board Systems (BBS) dans les années 1980 aux États-Unis, puis les forums de discussion des années 1990 et 2000 ou, au début des années 2000 en France, avec l’usage du minitel (Schaffer & Thierry, 2012), les communautés d’utilisateur-rices ont été confrontées à la nécessité de définir les normes de ce qu’il était possible de dire et de montrer dans les espaces numériques. Ces espaces reposaient largement sur des formes d’automodération (Seering, 2020) de modération communautaire souvent incarnées par des modérateur-rices bénévoles (régulièrement appelé-es « modos » dans le contexte francophone). L’émergence des réseaux sociaux numériques à la fin des années 2000 a toutefois profondément transformé l’échelle et la nature de ces pratiques. La concentration des usages sur un nombre limité de plateformes associée à une augmentation massive des volumes de contenus produits et diffusés a progressivement conduit à une centralisation drastique des processus de modération dans les mains des détenteurs de grandes plateformes.
Dans le débat public, cette modération à grande échelle est fréquemment abordée comme une réponse miracle aux problématiques associées aux environnements numériques (désinformation, discours haineux, harcèlement, contenus illicites). Néanmoins, son analyse montre qu’elle ne constitue pas un processus neutre (Gillespie, 2018). Elle participe de manière structurante à l’exercice d’un pouvoir économique, social et politique par les plateformes (Smyrnaios, 2025), en contribuant à définir les conditions de visibilité et d’invisibilité des contenus (Grison, 2024a).
Modération, régulation et recommandation
Il convient de distinguer, tout en reconnaissant leur articulation, trois échelles souvent confondues : la régulation, la modération et la recommandation.
La régulation renvoie à l’ensemble des dispositifs juridiques et institutionnels encadrant l’activité des plateformes. Elle est mise en œuvre par des autorités publiques et vise à imposer des obligations, notamment en matière de retrait de contenus illicites ou de gestion des risques systémiques. À l’échelle de l’Union européenne, elle est notamment définie dans le cadre du règlement européen sur les services numériques, applicable depuis le 17 février 2024, visant à lutter contre la propagation de contenu illicite en ligne[1].
La modération désigne les pratiques internes par lesquelles les plateformes appliquent leurs propres règles aux contenus publiés par les utilisateur-rices. Elle repose sur des normes définies de manière autonome par les entreprises et diverge donc d’un réseau social à l’autre (Gillespie, 2019). Autrement dit, si les plateformes sont tenues de respecter les lois locales dans lesquelles elles distribuent leurs services, elles capitalisent aussi sur leurs spécificités pour se démarquer sur le marché (Roberts, 2019).
La recommandation, quant à elle, correspond aux mécanismes algorithmiques de hiérarchisation et de mise en visibilité des contenus. Loin d’être distincte de la modération, elle en constitue une extension : valoriser certains contenus implique nécessairement d’en marginaliser d’autres (Grison, 2024a). Elle fonctionne selon des critères plus ou moins personnalisés et géolocalisés et, de la même manière, est propre à chaque plateforme au point de constituer une forme de « recette secrète » volontairement gardée opaque par les entreprises qui les déploient (Roberts, 2019).
Tout cela témoigne donc, en somme, d’un processus d’éditorialisation propre à chaque réseau social (Grison, 2024a). En définitive, il faut bien comprendre que les réseaux sociaux numériques ne se limitent pas à un rôle d’hébergement technique de contenus que les internautes auraient postés ; elles structurent les formes et les conditions d’expression dans l’espace public numérique, notamment à travers les formats qu’elles privilégient et les normes qu’elles imposent.
Les manifestations de la modération : une pluralité de dispositifs de gestion de la visibilité
La modération ne se réduit pas à la suppression de contenus. Elle se décline en une diversité de mécanismes qui agissent à différents niveaux sur la visibilité des publications et des utilisateur-rices.
-La suppression constitue la forme la plus explicite : un contenu est retiré lorsqu’il enfreint les règles de la plateforme ou la législation en vigueur. Cette suppression peut se faire en amont d’une publication ou a posteriori, après que le contenu a été identifié comme indésirable en ligne.
-La suspension concerne les comptes des utilisateur-rices. Elle peut être temporaire ou répétée, en fonction de la gravité des infractions. Il s’agit d’une interdiction temporaire d’accès à son compte ou à la publication pour l’utilisateur-rice.
-La démonétisation agit sur les conditions économiques de production des contenus. Elle consiste à priver certains contenus de revenus publicitaires, tout en les maintenant accessibles. Ce mécanisme peut affecter de manière différenciée certains types de discours, notamment lorsqu’ils portent sur des sujets sensibles ou controversés. Cela peut donc conduire à affecter le modèle économique de créateur-rices de contenus, de militant-es ou de médias, par exemple.
-D’autres dispositifs visent à moduler l’accès aux contenus. Le blocage géographique permet d’adapter la diffusion aux contraintes juridiques locales (par exemple, en matière de contenus portant sur l’éducation à la sexualité ou de militantisme LGBTI+ dans des pays où l’homosexualité est interdite), tandis que des avertissements ou dispositifs de floutage introduisent des seuils d’accès gradués pour les contenus jugés sensibles.
-Enfin, des formes plus discrètes de modération reposent sur la réduction de la visibilité, notamment à travers le déréférencement ou la limitation algorithmique de la portée des contenus et des comptes. Ces pratiques, parfois qualifiées de shadowbanning (Are, 2022 ; Grison, 2024b), se caractérisent par la difficulté pour les internautes à repérer que leur contenu fait l’objet d’une invisibilisation et donc éventuellement à faire appel pour exercer leur droit face à une censure qu’ils et elles jugeraient abusive. Il s’agit d’une stratégie de modération de plus en plus employée par les plateformes pour éditorialiser les contenus en ligne sans prendre le risque de voir leur image de marque altérée en cas de polémique sur une censure que des communautés numériques ou des médias auraient considéré comme abusive.
L’ensemble de ces dispositifs rend compte d’une gestion graduée et différenciée de la visibilité, qui dépasse largement la seule logique de censure explicite mais témoigne, là aussi, de la stratégie socio-technique des plateformes dans l’architecture de la visibilité en ligne et donc, de décisions politiques sous-jacentes.
Les piliers de la modération : textes, travail humain et machines
La mise en œuvre de la modération repose sur l’articulation de trois composantes principales : des cadres normatifs, des acteurs humains et des systèmes techniques.
-Le cadre normatif : les règles communautaires ou Community Guidelines. Les plateformes définissent des ensembles de règles encadrant les contenus autorisés, promus, restreints ou interdits. Ces documents, distincts des conditions générales d’utilisation – qui portent plutôt sur des aspects strictement contractuels et juridiques – visent à rendre explicites les normes applicables aux utilisateur-rices. Ils combinent des objectifs juridiques (limitation de la responsabilité) et économiques (préservation de l’attractivité pour les annonceurs), tout en s’inscrivant dans des stratégies de communication valorisant certaines valeurs (sécurité, inclusivité, respect). Ces règles sont influencées par des contraintes externes, notamment les exigences imposées par des acteurs tiers tels que les distributeurs d’applications (Apple Store, Google Marketplace, etc.). Enfin, il convient de noter que les règles rendues publiques par les entreprises ne sont pas les mêmes que celles qui circulent en interne, à destination des modérateur-rices ou des concepteur-rices d’algorithmes d’aide à la modération. En d’autres termes, on peut se demander si ces Community Guidelines ne constituent pas davantage des outils marketing pour les plateformes que de véritables indications précises pour les internautes.
-Le travail humain de la modération. Malgré le développement des outils automatisés, la modération repose encore largement sur une intervention humaine. Elle s’organise de manière hiérarchisée, depuis les équipes chargées de définir les principes structurants de la modération jusqu’aux opérateur-rices chargé-es du traitement quotidien des contenus signalés. Une part importante de ce travail est externalisée et sous-traitée, souvent dans des conditions de travail précaires (Casilli, 2019 ; Nakamura, 2017). Les modérateur-rices sont exposé-es de manière répétée à des contenus potentiellement traumatisants, ce qui soulève des enjeux documentés en matière de santé mentale en plus de leur exploitation. Par ailleurs, les internautes eux-mêmes participent au processus de modération à travers les dispositifs de signalement (Smyrnaios & Papaevangelou, 2020). Cette contribution, non rémunérée, constitue un élément central du fonctionnement des plateformes et revient souvent, de façon disproportionnée, aux personnes déjà exposées et qui sont la cible des contenus illicites qu’il conviendrait de modérer. Pour le dire simplement, ce sont souvent les personnes victimes de propos haineux en ligne qui ont la charge de leur repérage et de leur signalement (Nakamura, 2017).
-L’automatisation de la modération : le rôle des algorithmes. Face à l’augmentation des volumes de contenus, les plateformes ont recours de manière croissante à des systèmes automatisés. Ces outils interviennent à différents stades, depuis la détection préventive de contenus interdits jusqu’au traitement des signalements. Les algorithmes permettent une intervention à grande échelle, mais présentent des limites importantes. Leur fonctionnement, souvent opaque, rend difficile l’évaluation de leurs critères de décision. En outre, ils peinent à interpréter des éléments contextuels tels que l’ironie, la satire ou les usages militants du langage, ce qui peut conduire à des erreurs de classification et à des enjeux dits de « discrimination algorithmique » (Grison, 2024a).
La centralisation de la modération de contenus constitue aujourd’hui un point essentiel pour comprendre le fonctionnement des plateformes numériques. Elle ne se limite ni à une contrainte technique ni à une obligation juridique, mais participe pleinement à la structuration de chaque espace public numérique et de ses spécificités. La modération repose donc sur un équilibre complexe entre des cadres normatifs, de la main-d’oeuvre humaine exploitée et des technologies automatisées. Enfin, les pratiques de modération soulèvent des tensions entre les principes affichés par les plateformes et leurs effets concrets, notamment en matière de visibilité des contenus et des acteur-rices. Leur analyse met en évidence les enjeux politiques et sociaux associés à la gouvernance des environnements numériques contemporains. En d’autres termes, si la modération apparaît dans certains cas comme une nécessité morale, juridique et éthique pour lutter contre la prolifération de contenus illicites et leur exposition auprès de publics vulnérables, elle fait également l’objet d’un certain nombre de contestations, de luttes et de stratégies d’évitement par les internautes. Le changement de règles chez Meta annoncé par Mark Zuckerberg en janvier 2025 illustre parfaitement cela : du jour au lendemain, une décision politique peut transformer un contenu haineux à l’encontre de communautés LGBTI+ en contenu toléré, causant des torts irréparables à des mouvements sociaux ou à des communautés minorisées[2]. Pour l’ensemble de ces raisons, la modération – et son pendant, la censure – fait l’objet de polémiques récurrentes, de mobilisations, de nouvelles réglementations et d’actes de résistance ou d’évitement par les internautes. Pour publier sans se faire censurer, les internautes jouent donc d’un nombre infini de tactiques.
Les tactiques pour éviter la censure en ligne
Face à cette « machine à faire taire » (Grison, 2024a), les internautes développent des tactiques de contournement caractérisées par une grande inventivité qui réactivent de vieilles traditions linguistiques. Pour reprendre la distinction célèbre du philosophe Michel de Certeau (1994), si les plateformes imposent une stratégie (l’organisation du pouvoir et de l’espace par l’institution), les internautes déploient des tactiques (l’art du « perruquage » et de la ruse au sein d’espaces contraints). Pour ce court article, nous faisons le choix d’aborder ces tactiques sans distinguer les communautés entre elles. En effet, si la démarche est la même, les manifestations de ces tactiques divergent d’une communauté et d’une thématique à l’autre.
Le cryptolangage et l’algospeak : tromper la machine par le texte
Pour détecter les contenus indésirables d’une part, et pour recommander les contenus populaires d’autre part, la modération (algorithmique) a longtemps fonctionné quasi exclusivement sur le repérage de mots-clés contenus dans les hashtags, les descriptions, etc. Dans l’ouvrage pionnier de Tarleton Gillespie sur la modération des plateformes, l’auteur explique que c’est notamment ce filtrage par mot-clé qui a conduit à la censure abusive de certaines communautés (2018). Il cite notamment l’exemple du ciblage du hashtag « gay » qui est régulièrement identifié, par les dispositifs de modération, comme abritant un nombre important de contenus à caractère pornographique et fait donc l’objet d’une modération quasi systématique sur les plateformes. Or, cette assimilation a également causé de nombreuses suppressions de contenus et de suspensions de comptes détenus par des personnes ouvertement homosexuelles qui employaient ce mot-clé pour s’identifier en ligne. Pour éviter que leurs contenus ne soient automatiquement détectés, démonétisés ou invisibilisés, les internautes ont donc développé toute une série de tactiques linguistiques pour éviter de faire l’objet d’une censure discriminante.
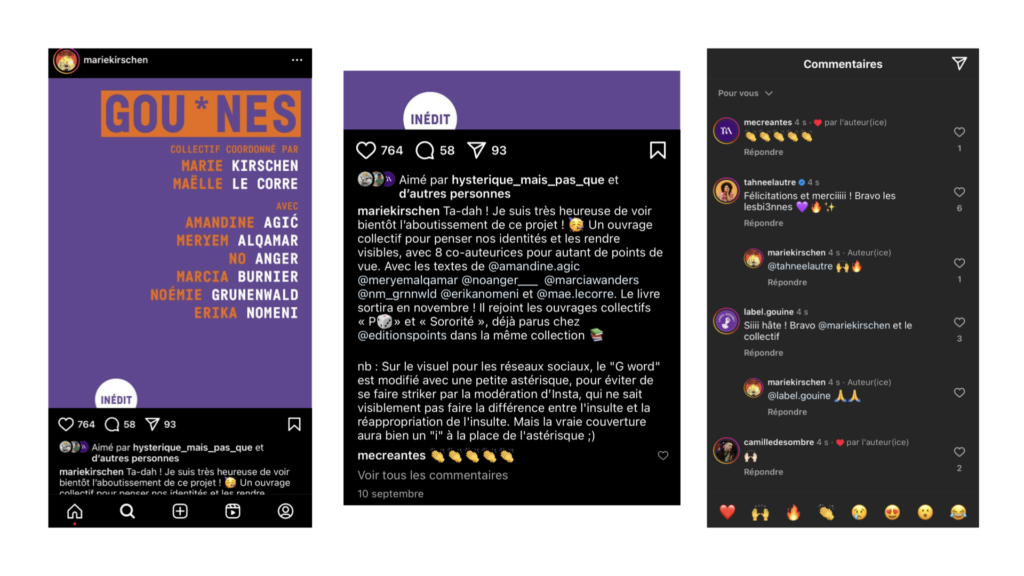
La capture d’écran ci-dessus montre un exemple de cette tactique linguistique sur les réseaux sociaux numériques : anticipant une éventuelle modération du mot « gouine » qui pourrait s’apparenter à un propos injurieux pour les dispositifs de modération, une des autrices de l’ouvrage militant remplace la lettre « i » par un astérisque pour éviter de voir son contenu invisibilisé sur Instagram. On appelle cela l’algospeak (qu’on traduirait par « la langue des algorithmes », en français). Cette tactique consiste à inventer des néologismes pour employer des mots-clés potentiellement identifiables comme « illicites » ou « sensibles » par les algorithmes. Autrement dit, il s’agit d’une tactique d’autocensure partielle pour éviter de faire l’objet d’une censure totale. Ce cryptolangage repose sur plusieurs ruses linguistiques et typographiques visant à brouiller la reconnaissance automatique des caractères, tout en restant compréhensible pour les autres usagers humains. Il s’agit de remplacer des lettres par des chiffres ou des symboles visuellement proches. On écrira par exemple « g4y » pour gay, « l3sbi3nn3 » pour lesbienne, ou « p0rn » pour porn. Ce langage s’appuie également sur un détournement sémiotique des emojis. Une combinaison spécifique peut servir à contourner les filtres sur les insultes (ou leur réappropriation). L’utilisation de l’émoji « coup de vent/pet » suivi d’un émoji « dé », par exemple, est utilisée pour signifier « pédé » : 💨🎲 De même, des combinaisons d’émojis fruits ou légumes sont couramment utilisées pour évoquer des concepts sexuels : 🍆 🍑. La chercheuse Emily van der Nagel (2018) a, dans sa recherche, comparé ces tactiques à du voldemorting, en référence à la saga Harry Potter de J. K. Rowling dans laquelle Lord Voldemort ne peut être nommé : il est désigné comme « Celui-dont-on-ne-doit-pas-prononcer-le-nom ». De même, dans son article sur le « Le Parler Fransais Des Gilles Et John » (2019), Alexandra Saemmer, chercheuse en sciences de l’information et de la communication, explique comment les Gilets Jaunes passent sous les radars de la modération en altérant volontairement l’orthographe de certains mots pour « in-communiquer avec la machine ». De nombreux travaux s’intéressent également aux enjeux de dog whistle sur les réseaux sociaux et étudient comment les communautés, notamment d’extrême droite, parviennent à diffuser des contenus néo-nazis et masculinistes en passant sous les radars de la censure. Enfin, Laurène Renaut étudie également l’inventivité dans les tactiques mises en place pour faire l’apologie du terrorisme et des djihadistes en ligne (Renaut, 2019). En définitive, la pratique du cryptolangage semble inhérente à l’usage des réseaux sociaux numériques, dès lors qu’on s’inscrit contre les règles des plateformes ou qu’on estime qu’elles discriminent nos prises de parole en ligne.
Si ces tactiques d’algospeak sont nombreuses et disparates, il est important de les inscrire dans une longue tradition des cryptolangages, au-delà des espaces numériques. Elles rappellent, en effet, l’usage du javanais au XIXe siècle, par exemple : « une langue cryptique spéciale des prostituées françaises du XIXe siècle qui, à en croire les historiens, l’avaient inventée pour se protéger de leurs clients. Il consiste à insérer, après chaque syllabe d’un mot français courant, un infixe commençant par la consonne v et faisant, en général, assonance avec la voyelle précédente » (Heller-Roazen, 2017). En somme, le cryptolangage désigne tous ces langages rendus inintelligibles à autre que qui de droit. « Chaque fois, ces formes de langage peuvent s’avérer impénétrables aux locuteurs non informés des langues dont elles constituent pourtant des déformations certes subtiles mais régulières », écrit Daniel Heller-Roazen, auteur d’un ouvrage en linguistique nommé Langues obscures. L’art des voleurs et des poètes (Heller-Roazen, 2017). Pour les jeunes publics contemporains, c’est aussi une manière de recréer un entre-soi protecteur, un langage codé que ni l’institution, ni les parents, ni les algorithmes ne peuvent immédiatement déchiffrer. En dehors des réseaux sociaux numériques, on pense par exemple à l’usage de l’encre invisible, aux langages codés ou à la langue de feu (un dérivé du javanais). En bref, il s’agit donc de tactiques linguistiques destinées à se faire comprendre par ses pairs dans des espaces publics contraints ou hostiles.
Au-delà du texte : la créativité multimodale (images, sons et vidéos en direct)
Bien que le contournement textuel soit le plus connu, il est loin de résumer toute l’inventivité déployée par les internautes pour échapper à la censure. En effet, les dispositifs techniques de modération ne se limitent pas à l’écrit : ils analysent désormais les images, les vidéos et les bandes-son grâce à des technologies de reconnaissance visuelle et vocale de plus en plus sophistiquées. Face à cette surveillance automatisée, la créativité tactique des usagers s’étend inévitablement à la multimodalité des formats proposés par les plateformes.
-Brouiller la reconnaissance visuelle : Pour contourner la détection automatique de contenus jugés choquants, les internautes modifient la structure de l’image. Cela passe par l’ajout de filtres, de recadrage, ou l’utilisation de stickers et d’émojis stratégiquement placés. Dans le cas de la nudité, il va s’agir d’utiliser des filtres qui rendent invisibles les pixels de peau, par exemple. D’autres internautes se mettent également en scène en train de se maquiller ou de faire des chorégraphies – contenus extrêmement populaires sur TikTok – pour faire passer leur contenu comme relevant du divertissement alors que l’internaute relaie pourtant des contenus à caractère sensible ou politique (Cervi & Divon, 2023).
-Ruser avec le son et la voix : Les plateformes transcrivant automatiquement l’audio (pour le sous-titrage ou la modération), la diction doit, elle aussi, être adaptée. Des bips sonores sont intégrés au montage pour masquer un terme proscrit, tandis que certains mots sont délibérément mal prononcés ou épelés. Une autre tactique consiste à superposer un contenu sensible à une musique virale : l’algorithme va ainsi recommander la publication en identifiant la bande-son tendance, favorisant sa diffusion malgré la nature du propos.
-Utiliser les vidéos en direct pour rediriger vers d’autres contenus : Les lives ou réels (vidéos en direct) et les stories éphémères (format vidéo de 24 h maximum) sont souvent plus délicates à modérer pour les plateformes. Pourtant, ces formats de vidéo font l’objet d’une forte mise en avant dans l’interface de réseaux sociaux comme Instagram et TikTok. Aussi, parce qu’ils sont largement populaires et parce que la modération y est plus difficile, les internautes les utilisent massivement pour promouvoir des contenus qui seraient probablement censurés s’ils avaient été postés sur des formats de post Ces espaces servent alors de zones d’expression plus libres, ou de relais pour rediriger l’audience vers des plateformes alternatives moins régulées. Ici encore, les fonctionnalités natives sont astucieusement détournées de leur usage premier.
En somme, l’ingéniosité des tactiques développées par les internautes prouve que la modération n’est jamais absolue. Elle est un jeu du chat et de la souris permanent (Grison, 2024b). Face à l’évolution constante des dispositifs de modération, les internautes renouvèlent sans cesse leurs pratiques et leurs modalités d’expression sémio-discursive en ligne. Cette créativité de l’esquive révèle que la lutte pour la visibilité sur les réseaux sociaux est une véritable compétence sociale et technique, particulièrement cruciale pour les communautés qui dépendent de ces espaces pour exister politiquement et culturellement.
Enjeux pédagogiques : vers une éducation à la recommandation algorithmique et à la modération des plateformes
Pour conclure cet article, nous proposons un exercice pédagogique à transmettre ou à réaliser avec de jeunes publics, en classe ou dans un cadre privé. Il s’agit d’un exercice inspiré d’un atelier de « sismographie des réseaux sociaux » proposé par Alexandra Saemmer lors du séminaire « GARNET » porté par le CERES et le projet ANR DATARights le 9 octobre 2025 à la Maison de la Recherche de Sorbonne Université. Les travaux d’Alexandra Saemmer portent plus largement sur la sémiotique sociale, définie par l’autrice comme suit : « la sémiotique sociale traque donc les « savoirs culturels et contextuels » et « les habitudes de pensée » qui agissent de manière implicite dans la perception » (Saemmer, Tréhondart et Coquelin, 2022). Pour le dire autrement, la sémiotique sociale est une méthode d’analyse de la construction du sens dont l’objectif est de sonder le caractère socialement situé des interprétations. Elle est régulièrement mobilisée dans le contexte pédagogique comme outil d’éducation aux images, aux médias et à l’information par des collègues en sciences de l’information et de la communication. Sans pour autant nous inscrire dans ce champ, il nous semble qu’une proposition d’atelier peut émerger de cet article pour créer le cadre d’une discussion entre élèves et enseignant-es/professeur-es documentalistes sur le fonctionnement politique et technique de la modération des réseaux sociaux.
Cet atelier d’auto-ethnographie vise à faire un « pas de côté » en sortant de la position d’usager-e passif-ve pour adopter celle d’observateur-rice critique de son propre environnement numérique. Le but n’est pas de diaboliser l’usage des plateformes, mais de rendre visibles les mécaniques de recommandation, la naturalisation des discours marchands et les éventuels biais de modération.
Proposition d’atelier d’auto-ethnographie : à partir de son fil d’actualité
Matériel requis : Un smartphone avec un ou plusieurs réseaux sociaux installés (TikTok, Instagram, YouTube, X, etc.), une feuille et un stylo.
Étape 1 : Le protocole d’observation (10 à 15 minutes)
L’exercice repose sur une consigne stricte de recueil de données :
Le choix du terrain : Ouvrez le réseau social de votre choix et rendez-vous sur la page de recommandation algorithmique principale (le fil « Pour Toi » sur TikTok, l’onglet « Explorer » ou les « Reels » sur Instagram, la page d’accueil YouTube).
La collecte : Faites défiler votre fil (scrollez). Pour les 20 premiers contenus qui apparaissent, notez immédiatement sur votre feuille les tout premiers mots que vous entendez ou lisez (texte incrusté, légende, phrase d’accroche, mots prononcés : à vous de voir mais restez constant dans ce que vous choisissez de noter).
Le marquage : Ajoutez un symbole (par exemple un astérisque *) à côté de votre note si le contenu porte la mention « Sponsorisé », « Partenariat rémunéré » ou s’il s’agit manifestement d’un placement de produit. Notez également à côté la thématique principale (ex : humour, beauté, politique, sport, actualité).
Étape 2 : L’analyse individuelle (5 minutes)
Une fois la liste de mots et de phrases établie, prenez le temps de la lire à froid, d’un seul trait. Ce texte, souvent absurde ou décousu, est une forme de photographie de ce que l’algorithme a choisi de vous montrer à un instant T. Il vous est spécifique mais peut-être que la mise en commun fera émerger des similitudes avec votre voisin.
Étape 3 : La mise en commun et le débat (30 à 45 minutes)
C’est ici que le travail de sémiotique sociale et d’éducation aux médias prend tout son sens. L’enseignant-e ou l’animateur-rice peut guider la discussion autour de quatre grands axes (ils sont donnés à titre indicatif mais peuvent faire l’objet d’une adaptation selon les priorités de l’enseignant-e) :
Axe 1 : Questionner l
Qu’est-ce que ce fil de mots dit de moi ? Les élèves sont invités à réfléchir à la différence entre ce qu’ils aiment réellement et ce sur quoi ils cliquent ou s’attardent. (Remarque : l’analyse et le partage de son propre fil de recommandation en public peuvent s’avérer gênants, voire intrusifs, pour certain·e·s participant·e·s. Il est donc essentiel de ne contraindre personne à s’exprimer, tout en prenant le temps de souligner ouvertement cette dimension intime. En effet, un fil d’actualité algorithmique est profondément personnel : bien qu’il soit constitué de publications créées par d’autres, il agit comme un miroir de nos habitudes, de nos curiosités ou de nos identités. Se voir ainsi « mis à nu » par une machine peut constituer une expérience particulièrement décontenançante. C’est là toute l’utilité de l’exercice mais dont il convient cependant de souligner le caractère potentiellement intime).
Comment expliquer cette personnalisation ? Est-ce que je fais partie des internautes qui likent sans poster de contenu ou bien suis-je très actif-ve en ligne ? Est-ce parce que j’ai passé beaucoup de temps à scroller ce type de contenus hier ? En bref, faire émerger des hypothèses sur la recommandation personnalisée (durée d’exposition/consultation des contenus, interaction, abonnements, cercle de proches, etc.)
Axe 2 : Économie de la donnée et naturalisation des contenus publicitaires
Combien de contenus sponsorisés avez-vous comptés sur 20 publications ?
Étaient-ils faciles à repérer ? La discussion doit porter sur la « naturalisation » de la publicité. Aujourd’hui, les annonces singent les codes esthétiques des vidéos amateurs pour s’intégrer dans l’écosystème du réseau social. La plateforme est avant tout une régie publicitaire, et la recommandation sert à insérer ces encarts marchands le plus fluidement possible. Cela donne l’occasion de présenter le modèle économique des GAFAM aux élèves.
Axe 3 : Qu’est-ce qu’on ne voit pas ?
Qu’est-ce qui manque dans votre liste ? En lien avec les parties I et II de notre article, et suite au partage collectif, il s’agit d’inverser le regard. Si l’algorithme vous enferme dans le confort de ce que vous connaissez déjà, quels sont les sujets, les esthétiques ou les communautés que vous ne voyez jamais ? Il s’agit là de la possibilité de discuter de la notion de « bulle de filtre » avec les élèves. Attention toutefois à bien prendre en compte que cette notion n’est pas consensuelle, parce que les réseaux sociaux permettent de se confronter à divers points de vue et parce que le monde « hors ligne » n’est pas exempt de « bulle de filtre » dans la façon dont on accède à l’information, par exemple.
Axe 4 : La comparaison des identités numériques et des spécificités pour chaque plateforme
Comparez les résultats entre différents réseaux sociaux. Un-e élève sur TikTok aura-t-il/elle une liste avec des mots plus axés sur l’émotion et le divertissement qu’un l’élève sur l’onglet Explorer d’Instagram, souvent plus axé sur l’esthétique ? Quelles différences entre les réseaux sociaux ?
Pourquoi cette différence ? Chaque plateforme éditorialise le monde selon son propre modèle économique et son propre public cible (voir partie I de l’article).
Conclusion de l’atelier
En définitive, cet atelier permet de faire comprendre de manière tangible que l’interface fluide d’un réseau social n’est pas une simple fenêtre ouverte sur le monde, mais un dispositif hautement construit, modéré, filtré et monétisé. Bien que son fonctionnement nous apparaisse opaque, comprendre les règles de cette matrice algorithmique, ainsi que les tactiques (comme l’algospeak) employées par ceux qui tentent d’y survivre ou d’y résister constitue donc des portes d’entrée pour comprendre ce que sont ces plateformes et les usages qui en sont faits. Cela permet de penser tout à la fois le caractère technique de ces plateformes mais aussi leur caractère éminemment politique.
Conclusion générale
La censure sur les réseaux sociaux numériques, qu’elle obéisse à des logiques techniques, idéologiques ou marchandes, demeure un phénomène particulièrement opaque : il est aussi difficile de l’étudier que de réaliser, en tant qu’utilisateur-rice, qu’on en fait l’objet. Au-delà de son caractère éminemment polémique, la censure sur les réseaux sociaux numériques pose une question fondamentale : qui porte la responsabilité de décider de ce qui mérite d’être vu en ligne ? Plus encore, quelles communautés et quelles idées doivent-elles faire l’objet d’une invisibilisation ou d’une hypervisibilisation ? Face à ce défi, l’argument de la difficulté à modérer et le volume incessant de contenus à modérer ne sauraient justifier une baisse de nos standards. Notre niveau d’exigence démocratique doit rester aussi intransigeant en ligne qu’il l’est en dehors. En effet, tout comme dans l’espace physique, où les frontières de ce qui peut être dit et montré fluctuent selon les époques, les cultures et l’échelle de l’audience, notre rapport à la parole numérique doit continuer de faire débat. Le nœud du problème réside peut-être précisément dans ce débat sans résolution : nous traitons ces plateformes tantôt comme des salons privés, tantôt comme des agoras, en oubliant que l’on ne s’exprime jamais de la même manière dans l’intimité de sa chambre, lors d’un dîner entre proches, devant une classe, dans un tribunal ou à la télévision. Autant de questions qu’il est bon de laisser en suspens sans attendre la bonne réponse, puisqu’il n’en existe sûrement pas et c’est là le propre des débats relatifs à la liberté d’expression et à la censure : ils sont tout aussi relatifs que fondamentaux pour nos sociétés.